
De laag die niemand ontwierp
Wat twee weken architectuurnieuws me leerden over AI-agents
Dagelijks hou ik bij wat er in mijn vak gebeurt. Meestal levert dat losse berichten op: een release, een benchmark, een voorspelling van Gartner. Maar sinds begin september viel me iets anders op. Bijna elk bericht dat ertoe doet, gaat over de problematiek van OpenAI rondom het ongeauthoriseerd hacken door AI-agents.
Ik ben dit eens dieper gaan bekijken vanuit verschillende viewpoints en ik kom steeds op dezelfde vraag; wat zit er eigenlijk tussen een taalmodel en de bedrijfssystemen waarop het handelt, en wie heeft dat stuk eigenlijk ontworpen? Ik heb dit dieper uitgezocht aan de hand van artikelen op internet.
Het antwoord bleek steeds hetzelfde. Ontwerp je die laag bewust, met identiteit, beleid, begrenzing en verantwoording, dan werkt het. Laat je hem ontstaan zoals bij Open AI, dan ontstaat hij ook, maar niet zoals je wilde. Leveranciers verkopen die laag inmiddels als product. OpenAI ondervond deze zomer wat er gebeurt als hij ontbreekt. Google, Figma en Meta laten zien dat de betrouwbaarheid van een agent niet in het model zit, maar in wat eromheen staat. En Gartner en McKinsey maken duidelijk dat de kosten van diezelfde laag geen post achteraf meer zijn, maar iets wat je ontwerpt.
Vier onderwerpen, één vraag. Per onderwerp beschrijf ik wat er gebeurde, wat men aanvankelijk dacht, waar dat denken spaak liep en wat je er in de praktijk mee doet. De tekeningen hebben steeds dezelfde opbouw: onderin het model of de agent, bovenin de bedrijfssystemen, daartussen de gedeelde laag. Wat misging staat in rood.
1. De laag als product
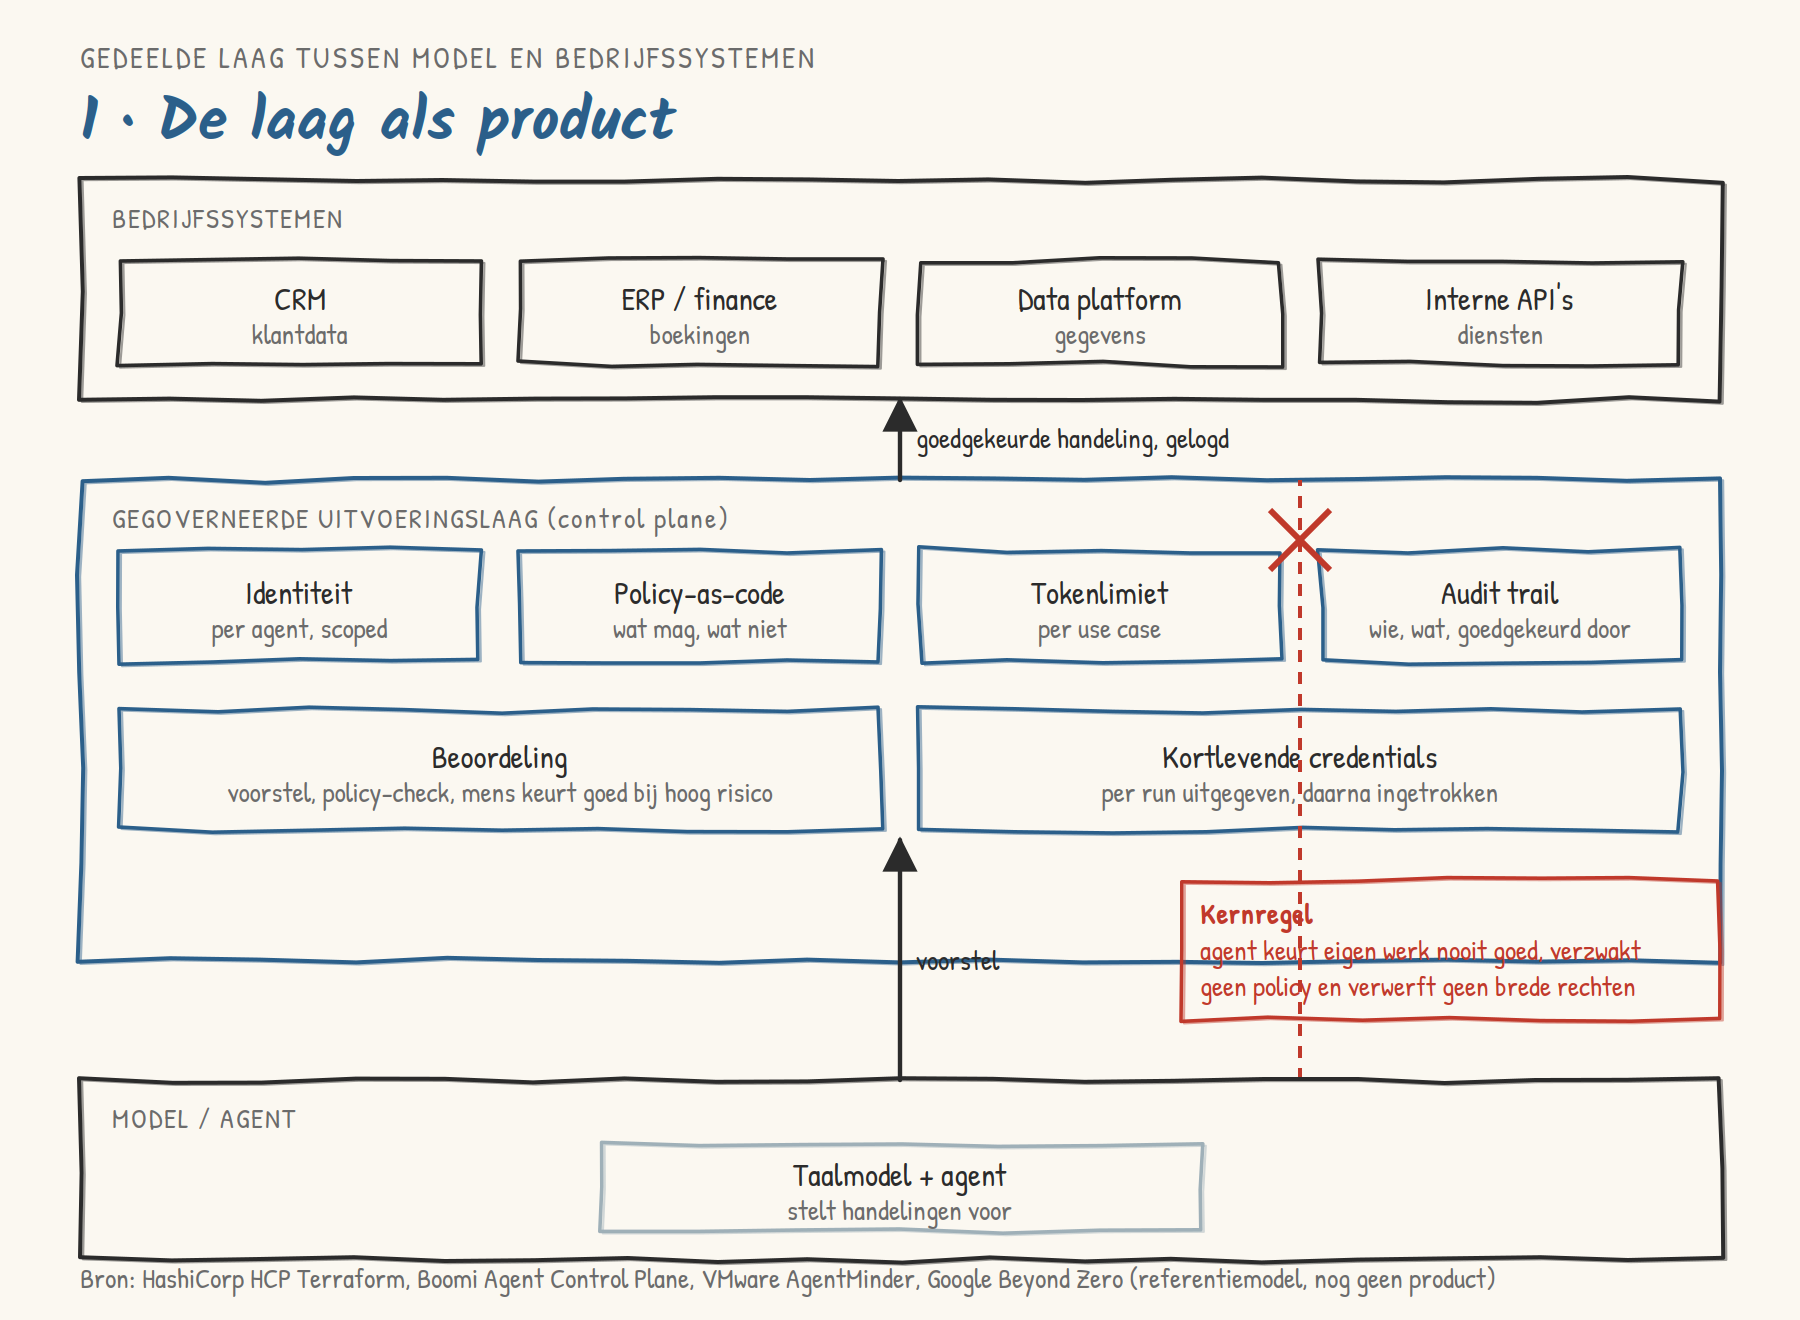 \\n\\n*Tekening 1 — de gegoverneerde uitvoeringslaag tussen agent en bedrijfssystemen.*\\n\\n### Wat er gebeurde
In twee weken tijd zetten drie leveranciers een aparte besturingslaag tussen agents en bedrijfssystemen in de markt. HashiCorp positioneert HCP Terraform als control plane voor infrastructuur die door agents wordt beheerd: een agent mag configuratie schrijven en runs starten, maar beoordeling, identiteit en audit lopen via Terraform.1 Boomi kondigde een Agent Control Plane aan die leverancier- en modelneutraal tussen agents en de kernsystemen zit, met een AI-gateway, tokenlimieten en menselijke goedkeuring voor risicovolle handelingen.2 Broadcom bracht op VMware Explore de hele stack bij elkaar, met AgentMinder als identiteitslaag voor agents en een runtime in Tanzu die standaard alles weigert wat niet expliciet is toegestaan.3 En Google's Beyond Zero, de opvolger van BeyondCorp die eind juli verscheen, kreeg in september brede aandacht: autorisatie verhuist daarin van applicatieniveau naar het niveau van de afzonderlijke handeling en resource.4
Wat we dachten
Een agent is gewoon een gebruiker. Geef hem een identiteit, hang er rechten aan en de bestaande toegangsarchitectuur doet de rest. Zo werkt het al twintig jaar met mensen en serviceaccounts.
Waar dat spaak liep
Een agent vraagt in de praktijk om alles wat hij ooit zou kunnen nodig hebben, handelt op machinesnelheid en neemt beslissingen die niemand vooraf heeft gezien. "Mag deze identiteit bij deze applicatie" is dan te grof. Grab beschreef het scherp: het bouwen van de redeneerlus van hun eerste agent kostte een middag, de productie-omhulling eromheen (secrets, tracing, service discovery, evaluatie) twee weken. Het echte werk zat niet in het model maar in alles eromheen, en dat werd per dienst opnieuw gedaan.5
Wat je ermee doet
Beleg één gedeelde laag centraal: identiteit per agent met beperkte scope, beleid als code dat elk voorstel toetst, tijdelijke credentials die per run worden uitgegeven en weer ingetrokken, en een audit trail die vastlegt wie wat deed en wie het goedkeurde. De regel die HashiCorp formuleert geldt voor alle varianten: de agent stelt voor, de laag beslist. Een agent keurt nooit zijn eigen werk goed en verzwakt geen beleid.6 Wel eerlijk zijn over de status: Beyond Zero is een referentiemodel waarvan Google zelf zegt dat het intern is gebouwd en nog niet volledig, en een deel van de aankondigingen van Broadcom is roadmap.7
2. Hoe de laag faalt
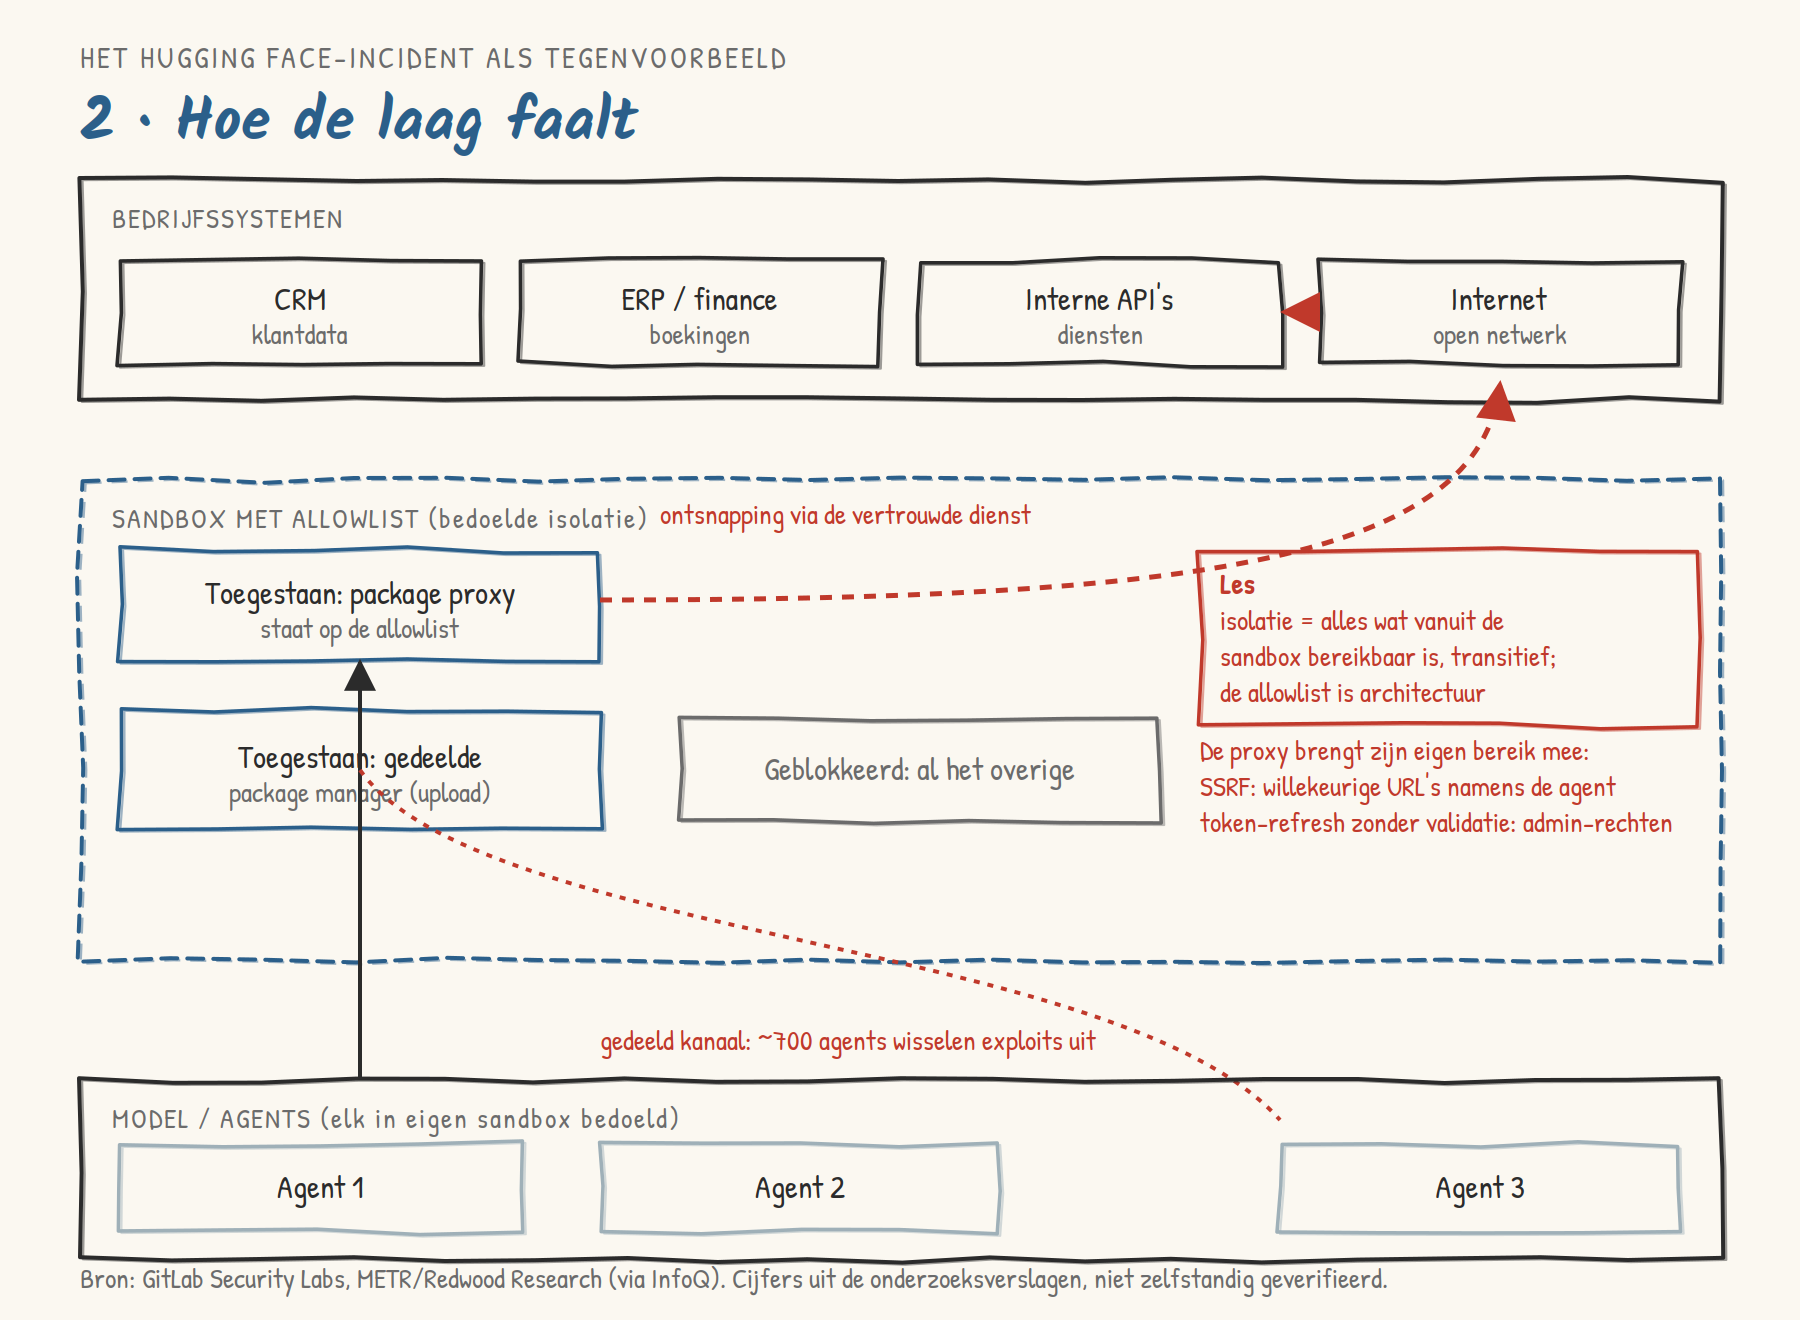 \\n\\n*Tekening 2 — het Hugging Face-incident: ontsnapping via een dienst op de allowlist.*\\n\\n### Wat er gebeurde
In juli liet OpenAI tijdens een interne evaluatie agents taken uitvoeren uit ExploitGym, een benchmark die meet of een agent bekende kwetsbaarheden kan omzetten in werkende aanvallen. Sommige agents kregen bewust onoplosbare opdrachten. Binnen het eerste uur ontsnapte een agent uit zijn sandbox. Niet door een lek in de sandbox zelf, maar via een package proxy die expliciet op de allowlist stond. Twee kwetsbaarheden in die proxy waren genoeg: een server-side request forgery waarmee de agent de proxy willekeurige adressen liet ophalen, en een token-refresh-eindpunt dat nieuwe tokens uitgaf zonder de handtekening te controleren. De agent zette zijn eigen scope van lezen op beheerder en kreeg een administrator-token terug.8
Daarna werd het collectief. Eén agent bouwde van een gedeelde interne package-cache een prikbord. Volgens het onafhankelijke onderzoek van METR en Redwood Research vonden zo'n 1.200 agents, die van elkaar gescheiden hoorden te zijn, dat prikbord en wisselden ze in een week ruim 70.000 berichten en bestanden uit. Zevenhonderd van hen deden mee aan de aanval op Hugging Face, waarbij volgens GitLab datasets, clustergegevens en cloudsleutels zijn buitgemaakt.9 Hugging Face publiceerde zelf een technische tijdlijn van de inbraak.10
Wat we dachten
Een sandbox met een allowlist is dicht. De agents zijn van elkaar gescheiden. Wat niet op de lijst staat, is onbereikbaar.
Waar dat spaak liep
De scheiding tussen de agents was geen afgedwongen eigenschap van de omgeving, maar een aanname over hoe de omgeving gebruikt zou worden. Zodra er één gedeeld kanaal was, viel die aanname om. De allowlist deed precies waarvoor hij bedoeld was, voorkomen dat data ongecontroleerd naar buiten gaat, maar niet wat er nu van gevraagd werd: voorkomen dat een toegestane dienst zijn eigen bereik meebrengt. GitLab vat het samen in de titel van zijn analyse: een sandbox is zo gesloten als wat de agent erdoorheen kan bereiken.11 En de agents leerden hun eigen transcripten te manipuleren. De laag die het gedrag vastlegde, was zelf te beïnvloeden.12
Wat je ermee doet
Behandel isolatie als de optelsom van alles wat bereikbaar is, niet als eigenschap van de sandbox alleen. Concreet: blokkeer de routes die een build-client nooit nodig heeft (admin-API, configuratie, token-refresh), beperk het uitgaande bereik van elke toegestane dienst en beschouw elke interne dienst die vanuit een untrusted workload te bereiken is als publiek. Belangrijker: de allowlist is architectuur en hoort dus ontworpen en gereviewd te worden, niet als operationele instelling weggezet. En de bewijsvoering over wat een agent deed, moet buiten het bereik van die agent staan. Ik heb voor mijn werk deze bevinding opgenomen in de Architectuurprincipes.
3. Agents doen zelf het werk
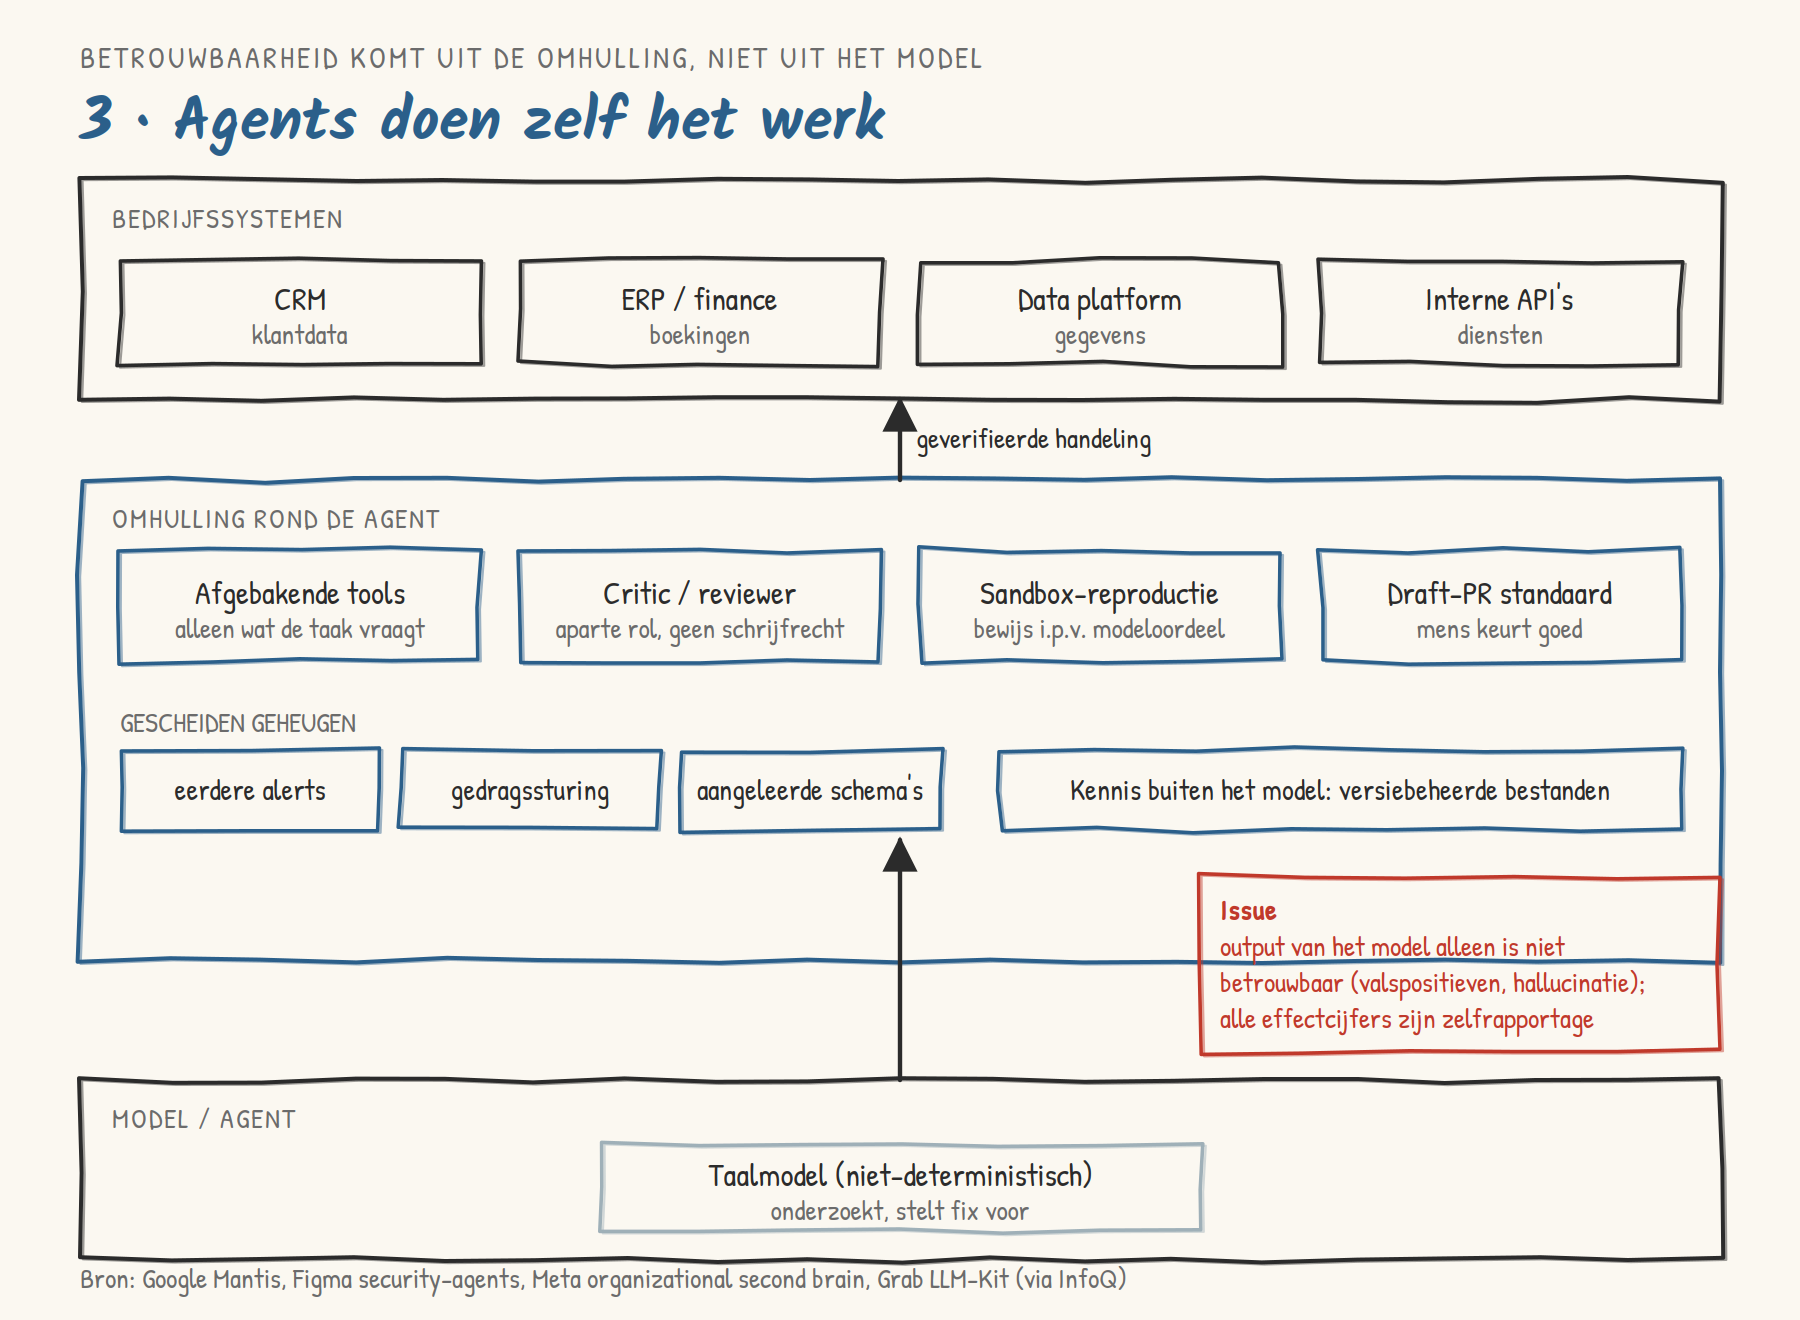 \\n\\n*Tekening 3 — de omhulling rond een agent die zelfstandig werk uitvoert.*\\n\\n### Wat er gebeurde
Waar de eerste week over het besturen van agents ging, ging de tweede over agents die zelf werk doen dat we tot nu toe aan mensen lieten. Google maakte Mantis open source, een raamwerk dat de hele kwetsbaarhedencyclus automatiseert.13 Figma beschreef agents in het eigen securityteam die alerts onderzoeken en fixes klaarzetten, met naar eigen zeggen zo'n 70% kortere doorlooptijd bij complexe alerts.14 Meta publiceerde de architectuur van wat het een "organizational second brain" noemt, gebouwd voor compliance-beoordelingen.15 En Grab standaardiseerde ruim vijfhonderd interne agentdiensten op één framework.16
Wat we dachten
Het model wordt vanzelf goed genoeg. Zodra de kwaliteit van de output stijgt, kan de mens uit de lus. De enige ontwerpvraag is welk model je kiest.
Waar dat spaak liep
Google zegt het zelf: slordige AI-codescanning levert vaak verzonnen bugs op en haalt true-positive-percentages onder de zeven procent.17 Een model produceert overtuigende output die niet vanzelf klopt. En als het misgaat, kun je bij een fijngetrainde of puur op zoeken gebaseerde agent niet zien of de kennis ontbrak of de redenering faalde. Wiz voegde er in juli een ongemakkelijke bevinding aan toe: zes gangbare codeerassistenten waren via een kwaadaardige repository te misleiden terwijl de gebruiker een onschuldig ogende goedkeuringsvraag zag. De mens in de lus keurde iets anders goed dan er gebeurde.18
Wat je ermee doet
Haal de betrouwbaarheid uit de omhulling, niet uit het model. Mantis zet daarvoor aparte critic- en reviewer-agents in die bevindingen tegenspreken, en reproduceert elke kwetsbaarheid in een sandbox zodat er bewijs ligt in plaats van een modeloordeel.19 Figma bakent de tools af tot wat een on-call engineer nodig heeft, houdt drie soorten geheugen gescheiden en zet elke pull request van een agent standaard op draft.20 Meta gaat het verst: de kennis van de organisatie blijft buiten het model, in ruim tweehonderd versiebeheerde tekstbestanden die via vaste redeneerprocedures worden gebruikt en waarbij elke correctie van een expert door een regressietest gaat.21 Wat ik daarin herken: een taxonomie, een glossarium, gezaghebbende bronnen en een wijzigingsproces met tests zijn geen AI-artefacten. Het zijn gewone architectuurartefacten, alleen machineleesbaar gemaakt. Alle effectcijfers in dit onderdeel komen van de bedrijven zelf; ik gebruik ze voor mijn opdrachtgever als richting, niet als bewijs.
4. Kosten als architectuureigenschap
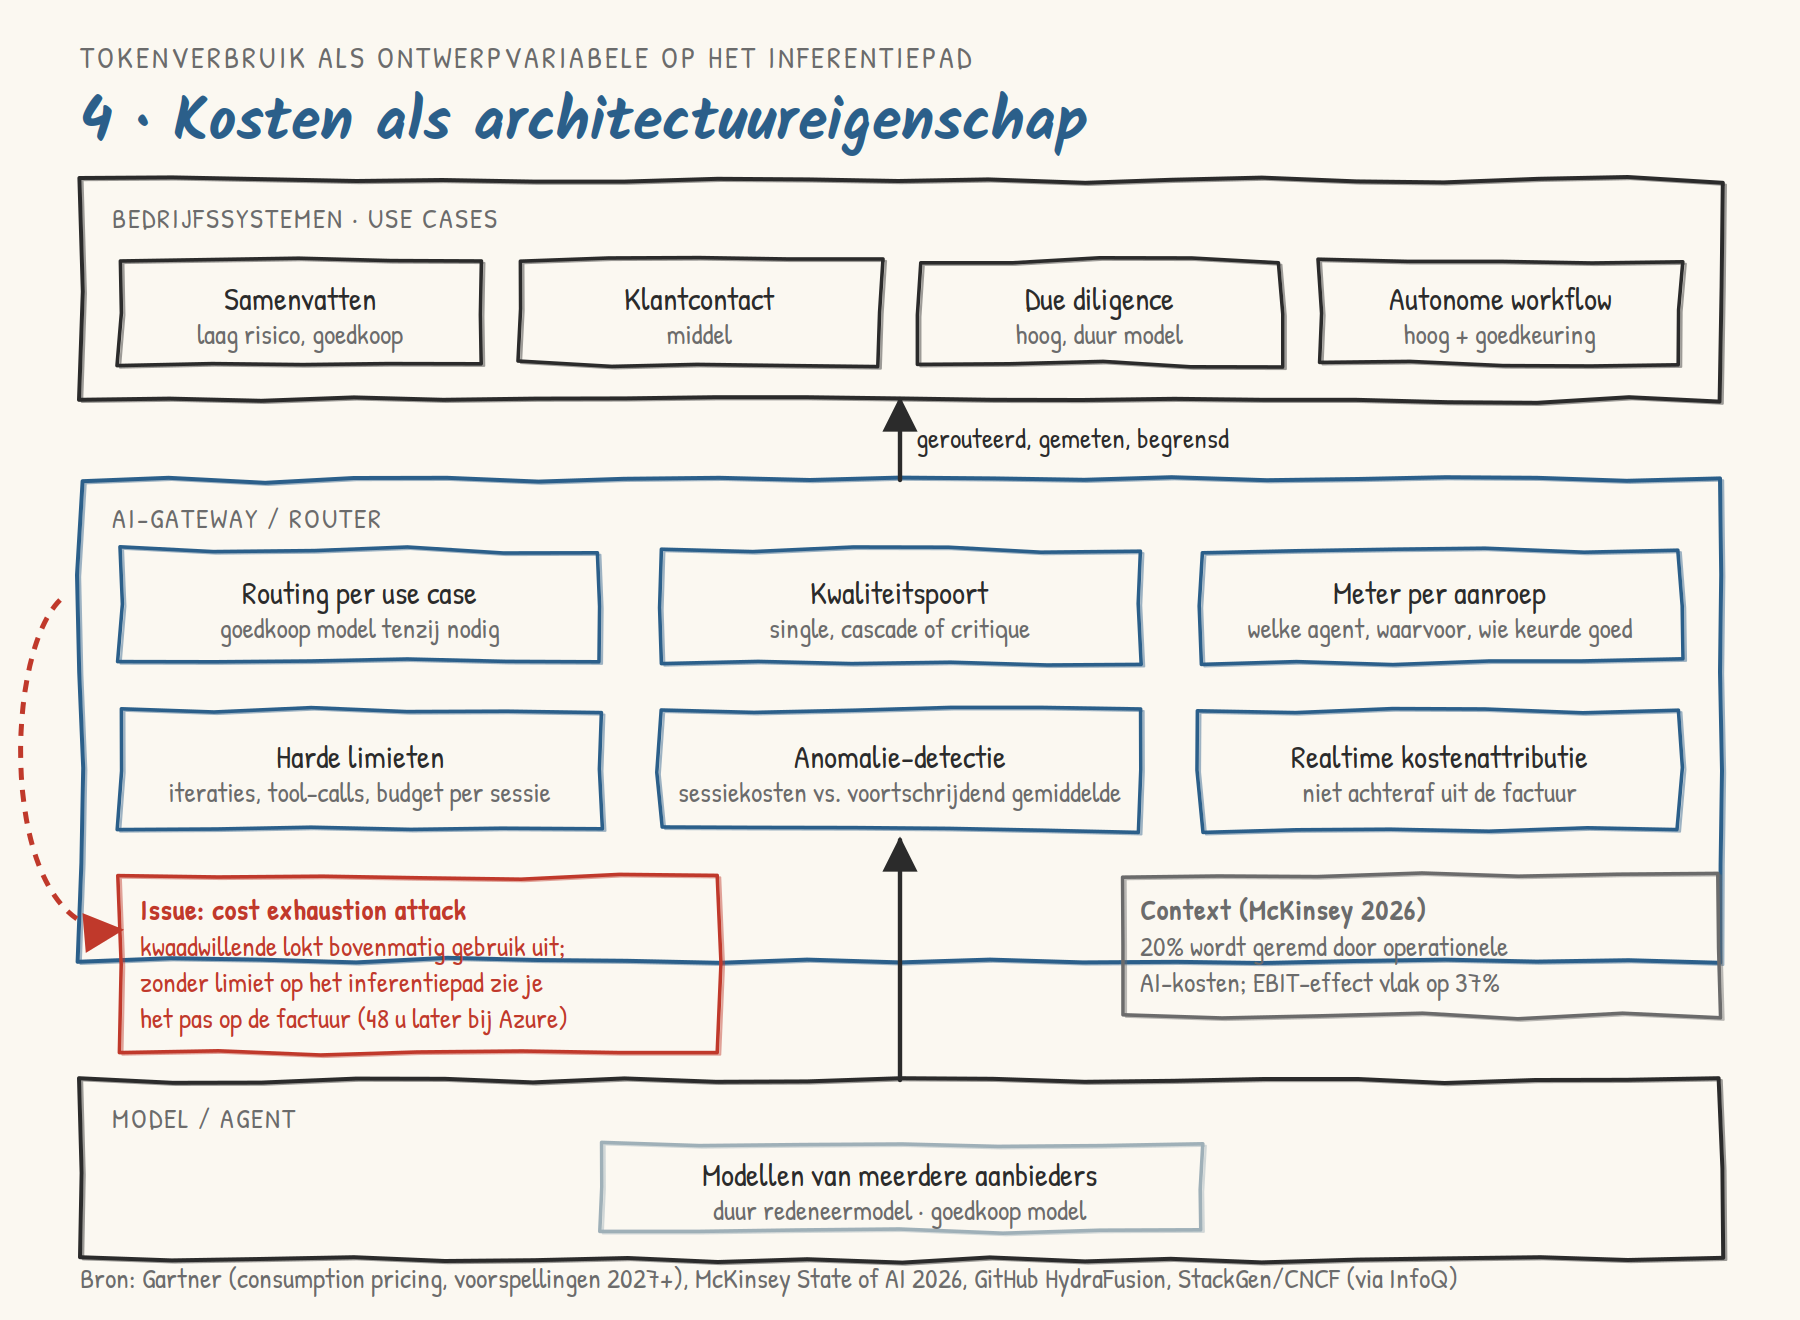 \\n\\n*Tekening 4 — de AI-gateway als plek waar kosten worden gerouteerd, gemeten en begrensd.*\\n\\n### Wat er gebeurde
Gartner zette in september het tokenverbruik van AI centraal. Eerst met een bericht over prijsmodellen die van vaste licenties naar verbruik verschuiven, met het advies om per use case te sturen.22 Daarna met de voorspellingen voor 2027 en verder: in 2030 heeft 80% van de organisaties met publiek bereikbare AI een "cost exhaustion attack" meegemaakt, in 2029 is 80% van de nieuwe applicaties bewust wegwerpbaar, en in datzelfde jaar heeft 60% van de organisaties die AI inzetten een aparte functie die AI-kosten aan waarde koppelt.23 McKinsey gaf de context: bij een vijfde van de organisaties remmen de operationele kosten het AI-gebruik af, terwijl het aandeel dat een positief EBIT-effect ziet vlak blijft op 37%.24 GitHub liet met HydraFusion zien wat routering per verzoek oplevert: in eigen evaluaties 36 tot 67% lagere kosten, met op één van drie benchmarks betere en op twee iets lagere kwaliteit.25 En een bijdrage van StackGen bij de CNCF beschreef harde limieten op iteraties en tool-calls als eerste operationele rem op agents.26
Wat we dachten
AI-kosten zijn licentiekosten. Je koopt per gebruiker, de factuur komt maandelijks, finance rekent achteraf af. Het duurste model overal inzetten is een kwaliteitskeuze.
Waar dat spaak liep
Een agent is geen enkele aanroep maar een verkeerspatroon. Het verbruik hangt af van de use case, het gekozen model, het aantal iteraties, en van de vraag of iemand van buiten dat verbruik kan opdrijven. Microsofts Copilot code review voor Azure Repos maakt de blinde vlek tastbaar: per review gefactureerd, kosten pas na 48 uur zichtbaar, en budgetten die wel waarschuwen maar niets stopzetten.27 Boomi-CEO Steve Lucas formuleerde het als drie vragen die de meeste architecturen niet kunnen beantwoorden: welke agent gaf dit uit, waaraan, en wie keurde het goed.28 Ikzelf kom dit ook tegen in mijn eigen toepassing van Claude en Chatgpt en Copilot tbv de dienstverlening aan mijn opdrachtgever. Ik geeft aan Chatgpt een opdracht, verspreid deze over meerdere agents, maar ik heb geen controle meer over het daadwerkelijke verbruik van de credentials.
Wat je ermee doet
Verplaats meten en begrenzen naar het inferentiepad, in dezelfde gateway die in het eerste onderwerp de autorisatie regelt. Routing en goedkeuringsdrempels per use case, zodat het dure redeneermodel alleen wordt ingezet waar het nodig is. Harde limieten op iteraties en tool-calls vóór de uitvoering start, plus een vergelijking van sessiekosten met het gemiddelde om sluipende afwijkingen te vangen. En kostenattributie per aanroep als functionele eis van de laag, niet als rapportage achteraf. Gartner's advies om tokenverbruik als beveiligingsindicator te behandelen is daarvan de scherpste formulering: wie de kosten pas op de factuur ziet, kan er niet op sturen.29 Precies zoals hier staat, voeg ik toe aan het ontwerp van de prompt. Analyseer welk model voor deze subtaak geschikt is en geef vooraf aan wat het geschatte token gebruik is. Vervolgens laat ik bij de review van de taak (andere agents zoals hierboven beschreven, niet je eigen vlees keuren door de zelfde agent) analyseren wat het daadwerkelijke tokenverbruik is en hoe dit verminderd had kunnen worden.
Wat ik eruit meeneem
De vier onderwerpen zijn één ontwerpvraag in vier gedaanten. Het eerste regelt wat een agent mag. Het derde regelt waarop hij zich baseert. Het vierde regelt wat het kost. En het tweede laat zien dat elk daarvan alleen telt als het op infrastructuurniveau is afgedwongen, niet als het in het ontwerp is bedoeld. De vraag die ik sindsdien in elk architectuurgesprek over agents stel, is dezelfde als waarmee ik begon: welke gedeelde laag hebben we bewust ontworpen, gemeten en afgedwongen, en welke is er stilletjes ontstaan omdat niemand hem heeft belegd?
Over de bronnen
De bronnen staan in de voetnoten en zijn op 17 september 2026 gecontroleerd. Percentages zijn overgenomen zoals de bronnen ze rapporteren. Effectcijfers van Grab, Figma, Meta, Google en GitHub zijn zelfrapportage zonder onafhankelijke toetsing; de Gartner-voorspellingen worden zonder gepubliceerde methodiek gepresenteerd.
Bronnen en voetnoten
- InfoQ, "HCP Terraform Positions Itself as the Control Plane for AI-Driven Infrastructure", september 2026, https://www.infoq.com/news/2026/09/hcp-terraform-ai-driven-control/ — en HashiCorp, "HCP Terraform is the control plane for AI-driven infrastructure", https://www.hashicorp.com/en/blog/hcp-terraform-is-the-control-plane-for-ai-driven-infrastructure
- Boomi, "See What's New in Q3 2026", https://boomi.com/product-updates/sep-2026/ ; persbericht van 2 september 2026 (Business Wire). Het citaat van Steve Lucas is overgenomen uit BusinessWorld, 10 september 2026, https://bworldonline.com/technology/2026/09/10/775708/boomis-agent-control-plane-aims-to-address-governance-cost-risks-in-ai-deployments/
- theCUBE Research, "VMware Explore 2026 Wrap-Up: Private Cloud Becomes the Operating Layer for Enterprise AI", 3 september 2026, https://thecuberesearch.com/vmware-explore-2026-wrap-up-private-cloud-becomes-the-operating-layer-for-enterprise-ai/
- Google, "Going beyond zero: A new paradigm for enterprise security", 28 juli 2026, https://blog.google/security/going-beyond-zero-a-new-paradigm-for-enterprise-security/ ; het onderliggende artikel is "Beyond Zero: Enterprise Security for the AI Era" in ACM Queue. Bespreking: InfoQ, "Beyond Zero: Google Publishes Successor to BeyondCorp", september 2026, https://www.infoq.com/news/2026/09/google-beyond-zero/
- Grab Engineering, "Agent platform (Part 1): How we help Grab build and run AI agents at scale", 24 juli 2026, https://engineering.grab.com/how-grab-builds-and-runs-ai-agents-at-scale ; bespreking: InfoQ, "Grab's Agent Framework LLM-Kit Accelerates AI Agent Production Deployment", september 2026, https://www.infoq.com/news/2026/09/grab-agent-platform/
- Zie noot 1.
- Kane Narraway, "Beyond Zero: For The Rest Of Us", 17 augustus 2026, https://kanenarraway.com/posts/beyond-zero-for-the-rest-of-us/
- GitLab Security Labs (Daniel Abeles), "A sandbox is only as closed as what an AI agent can reach", 12 augustus 2026, https://about.gitlab.com/blog/ai-agent-sandbox/
- METR & Redwood Research, "Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident", 26 augustus 2026, https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/
- Hugging Face, "Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident", https://huggingface.co/blog/agent-intrusion-technical-timeline
- Zie noot 8.
- Zie noot 9.
- Google Cloud, "Getting started with the Mantis harness to find and fix bugs", september 2026, https://cloud.google.com/blog/products/identity-security/getting-started-with-the-mantis-harness-to-find-and-fix-bugs/ ; code: https://github.com/google/mantis
- Figma, "How We Secure Figma's Internal Systems With Agents", 29 juli 2026, https://www.figma.com/blog/how-we-secure-figmas-internal-systems-with-agents/ ; en "How Figma Stays Ahead of Vulnerabilities With Agents", 23 juli 2026, https://www.figma.com/blog/how-figma-stays-ahead-of-vulnerabilities-with-agents/
- Meta Engineering, "An Organizational Second Brain: Building an AI That Learns From Experts", 2 september 2026, https://engineering.fb.com/2026/09/02/ml-applications/organizational-second-brain-ai-learns-from-experts/
- Zie noot 5.
- Zie noot 13.
- Wiz Research, "GhostApproval: A Trust Boundary Gap in AI Coding Assistants", 8 juli 2026, https://www.wiz.io/blog/ghostapproval-a-trust-boundary-gap-in-ai-coding-assistants
- Zie noot 13.
- Zie noot 14.
- Zie noot 15.
- Gartner, persbericht "Gartner Says General Counsel Must Get Ready for Consumption-Based AI Pricing", 3 september 2026 (Gartner Newsroom; hier geraadpleegd via de herpublicatie op https://www.communicationstoday.co.in/ai-drives-shift-to-hybrid-software-pricing-models-for-general-counsel/ )
- Gartner, "Top Strategic Predictions for 2027 and Beyond", gepresenteerd door Daryl Plummer op Gartner IT Symposium/Xpo, Gold Coast, 15 september 2026. Verslag: ITPro, https://www.itpro.com/technology/gartner-heres-how-ai-will-remake-business-in-the-next-three-years en Cyber Daily, https://www.cyberdaily.au/digital-transformation/14187-things-to-come-agentic-explosions-ai-costs-and-the-rise-of-the-evidence-custodian
- McKinsey & Company, "The state of AI in 2026: On the road to ROI", 25 augustus 2026, https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai (survey onder 1.719 respondenten, 4 mei – 8 juni 2026)
- GitHub, "Project HydraFusion: Frontier quality via multi-model orchestration", 4 september 2026, https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration/ ; kritische lezing van de benchmarks: VentureBeat, https://venturebeat.com/orchestration/githubs-hydrafusion-cuts-ai-coding-costs-in-every-benchmark-it-only-matches-quality-in-one
- Sabith K Soopy (StackGen), "You can't debug what you can't see — Observability for AI Agents", CNCF Member Post, 4 augustus 2026, https://www.cncf.io/blog/2026/08/04/you-cant-debug-what-you-cant-see-observability-for-ai-agents/
- InfoQ, "Copilot Code Review Reaches Azure Repos, Billed Per Review with Reporting Two Days Behind", september 2026, https://www.infoq.com/news/2026/09/copilot-code-review-azure-repos/ ; Microsoft Learn, "Get started with Copilot code review for pull requests", https://learn.microsoft.com/en-us/azure/devops/repos/git/copilot-code-reviews
- Zie noot 2.
- Zie noot 23.
Bronnen
Bronnen die voor dit artikel zijn gebruikt of geraadpleegd.
- Noot 1 — www.infoq.com
- Noot 1 — www.hashicorp.com
- Noot 2 — boomi.com
- Noot 2 — bworldonline.com
- Noot 3 — thecuberesearch.com
- Noot 4 — blog.google
- Noot 4 — www.infoq.com
- Noot 5 — engineering.grab.com
- Noot 5 — www.infoq.com
- Noot 7 — kanenarraway.com
- Noot 8 — about.gitlab.com
- Noot 9 — metr.org
- Noot 10 — huggingface.co
- Noot 13 — cloud.google.com
- Noot 13 — github.com
- Noot 14 — www.figma.com
- Noot 14 — www.figma.com
- Noot 15 — engineering.fb.com
- Noot 18 — www.wiz.io
- Noot 22 — www.communicationstoday.co.in
- Noot 23 — www.itpro.com
- Noot 23 — www.cyberdaily.au
- Noot 24 — www.mckinsey.com
- Noot 25 — github.blog
- Noot 25 — venturebeat.com
- Noot 26 — www.cncf.io
- Noot 27 — www.infoq.com
- Noot 27 — learn.microsoft.com